
Análisis del sobreajuste
Traducido del inglés. El texto en inglés es la referencia. Leer en inglés
Riesgo de sobreajuste
Resumen
- Como todas las estrategias de negociación sistemáticas, las estrategias AiLA se enfrentan al riesgo de basarse en resultados sobreajustados.
- Incluso con las mejores intenciones y siguiendo las mejores prácticas vigentes, no hay garantía de evitar el sobreajuste, por ejemplo, por dejarse influir involuntariamente por experiencias pasadas.
- Para tratar de minimizar activamente el efecto del sobreajuste, el desarrollo de las estrategias AiLA sigue estrictamente un conjunto de principios.
Esquema
- Tipos: resumen de las fuentes de sobreajuste que suelen considerarse en las distintas fases de I+D de una estrategia.
- Riesgo: se destacan los principales pasos del proceso de las estrategias AiLA en los que podría producirse sobreajuste.
- Mitigación: se describen los principios que sigue AiLA para reducir el riesgo de sobreajuste.
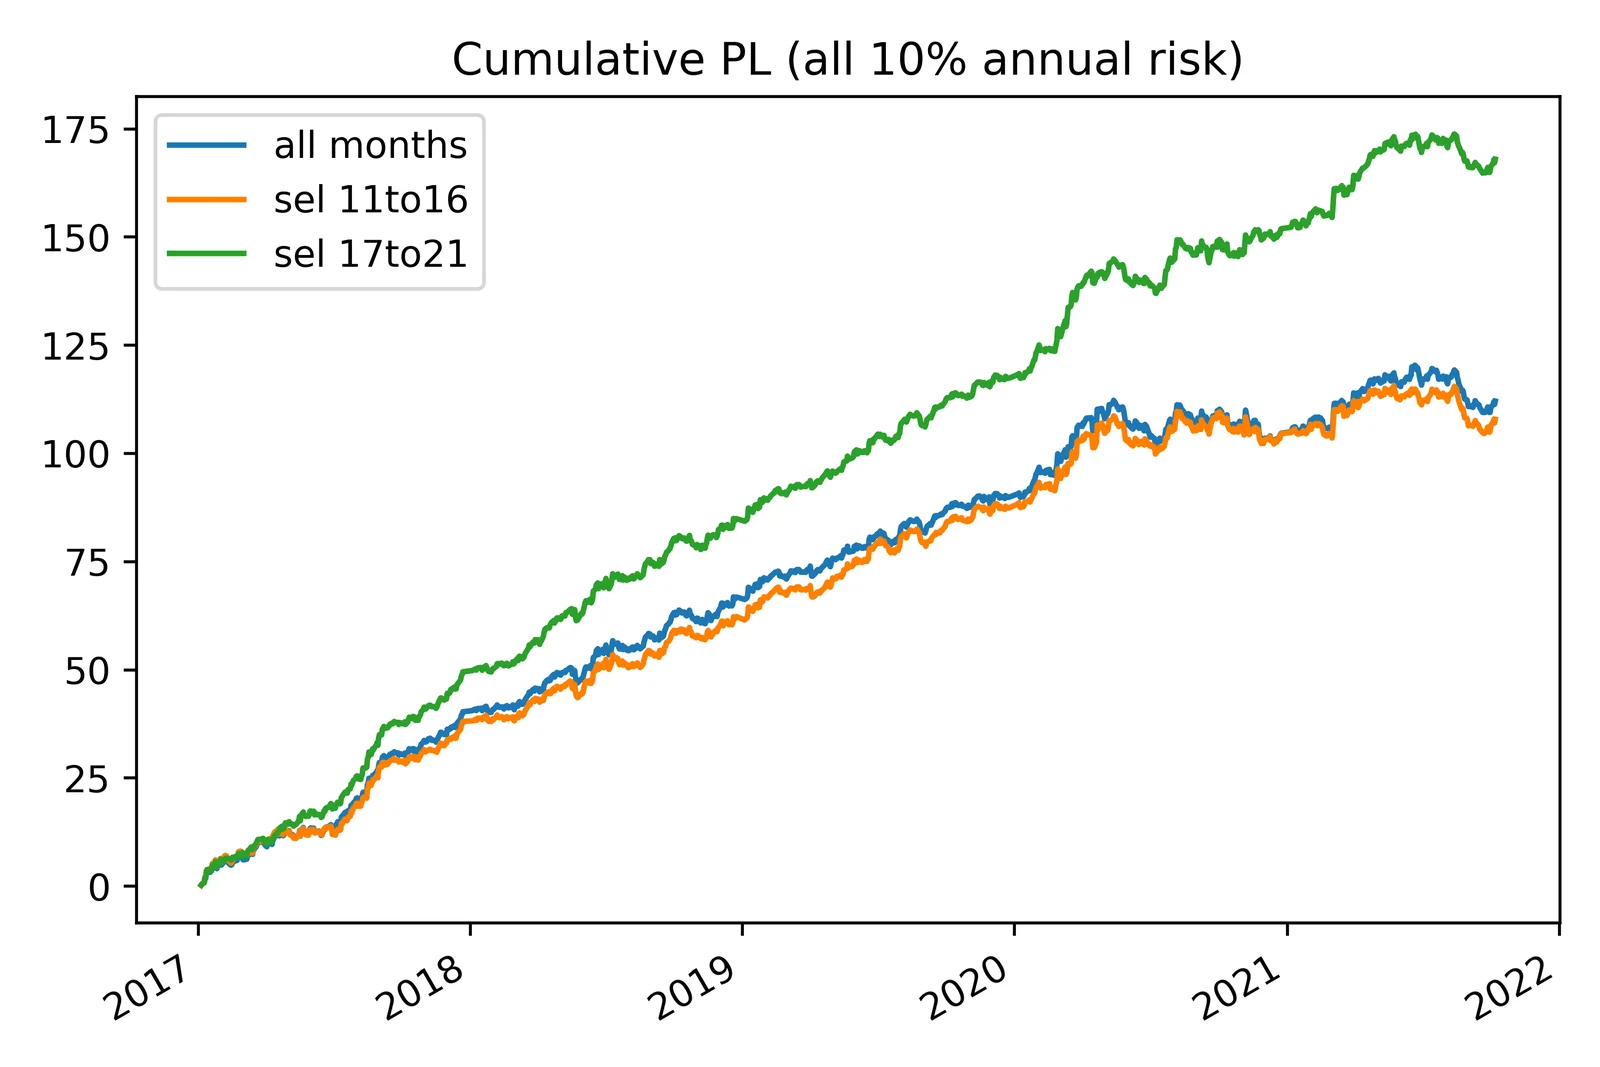
- Ilustración de resultados de una estrategia sobreajustada; para más detalles, véase la nota de Perspectivas [Overfitting Risk].
- Una mejora de la estrategia diseñada con los mismos datos que se utilizan para evaluarla muestra un rendimiento superior al de la estrategia por defecto (2017 a 2021).
- La misma estrategia mejorada, aplicada a datos distintos (2011 a 2016), indica que la hipótesis no tiene ningún efecto.
Tipos de sobreajuste
El sobreajuste suele analizarse en distintas fases del proceso de I+D; a continuación se describen dos tipos habituales.
La terminología es habitual en el aprendizaje automático (ML); sin embargo, los problemas no son exclusivos del ML, sino que afectan a cualquier ejercicio en el que se consulten datos.
Fase de entrenamiento (diseño)
- Se refiere al sobreajuste que se produce durante la fase de entrenamiento o diseño de la estrategia.
- En esta fase el sobreajuste es en cierta medida inevitable, y se utilizan distintos métodos para abordar los problemas derivados de ajustar una relación al ruido de los datos dentro de la muestra.
Fase de prueba
- Se refiere al sobreajuste que se produce durante la fase de prueba de la estrategia, en la que no se pretende ningún ajuste.
- Suele deberse a escenarios de pruebas múltiples, como «probar muchas y elegir la mejor» o «probar, cambiar y volver a probar», en los que en la evaluación final se pasa por alto (a menudo de forma involuntaria) el motivo que embellece los resultados.
Ejemplos de medidas para abordar el sobreajuste
Fase de entrenamiento (diseño)
- Se utilizan técnicas de validación cruzada para evaluar la capacidad de reproducir (generalizar) los resultados con datos fuera de muestra.
- Se utilizan técnicas de regularización para reducir la complejidad del modelo y su sensibilidad a la muestra de datos concreta.
- Pueden utilizarse modelos de conjunto (ensemble) para reducir la varianza de los resultados del modelo y hacerlo más robusto frente al sobreajuste.
Fase de prueba
- Llevar un registro de las múltiples pruebas realizadas y utilizar métodos para corregir o estimar su efecto, p. ej., pruebas de tasa de error por familia (familywise) o rendimiento deflactado.
- Aplicar una política estricta de registro previo de los detalles de las pruebas y de uso de datos distintos («ciegos»).
La ilustración anterior [Overfitting Risk] se detectó fácilmente mediante validación cruzada; sin embargo, el sobreajuste (involuntario) durante las pruebas suele ser mucho más difícil de cuantificar.
Áreas de riesgo
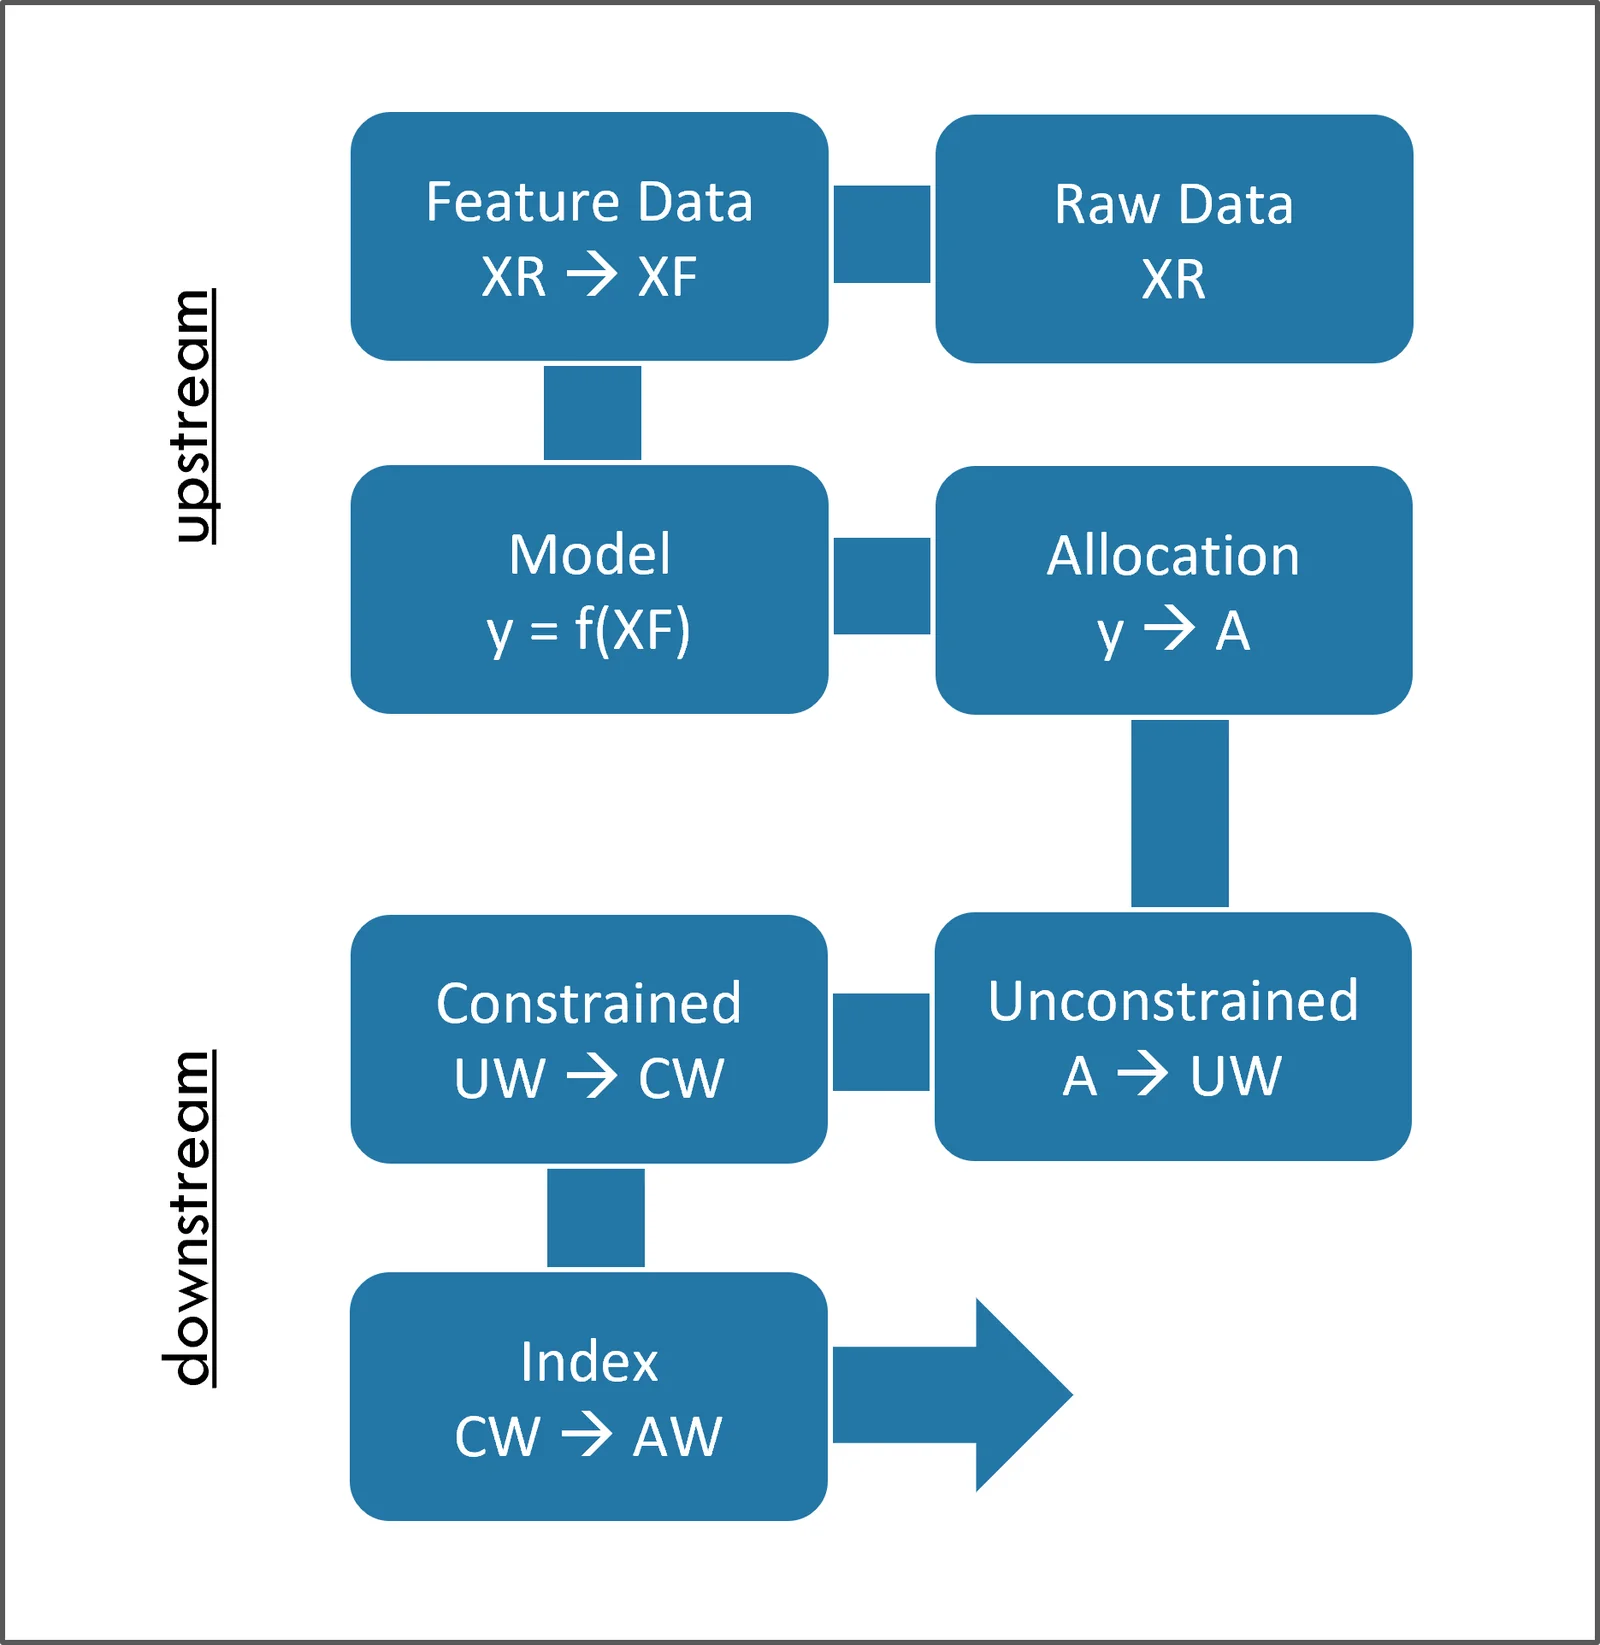
A lo largo del proceso de desarrollo de las estrategias AiLA hay varias ocasiones en las que puede producirse sobreajuste.
Áreas de especial riesgo
- Las decisiones sobre los datos micro/macro y la definición de las variables: se trata de permitir que los datos revelen los factores importantes sin presuponer cómo debe utilizarlos la estrategia.
- El entrenamiento y la selección de los modelos de activos. Aquí se utilizan técnicas como las mencionadas para abordar el sobreajuste, y toda la evaluación de los modelos y el ajuste de hiperparámetros se realizan con un conjunto de datos de entrenamiento/validación predeterminado.
- El método final de asignación del proceso previo (upstream) también se optimiza en cuanto a sus parámetros con el mismo conjunto de datos de entrenamiento/validación.
- La construcción de índices en el proceso posterior (downstream) combina distintos modelos de asignación de activos en índices de distintos tipos. Este proceso se basa en un método fijo, centrado en lograr un riesgo diversificado en toda la cartera más que en el rendimiento de los activos. No obstante, este paso incluye decisiones sobre parámetros y la selección de los activos del índice, en las que debe evitarse introducir un sesgo de selección.
Principios de mitigación
Para reducir el efecto del sobreajuste se siguen estrictamente una serie de principios.
No obstante, cabe señalar que todos los enfoques tienen limitaciones y que es necesario actuar con cautela en todas las decisiones.
Principios aplicados
- Todos los datos de las variables deben estar disponibles en el futuro previsible y, al igual que las definiciones de las variables, no se modifican una vez fijado el modelo del activo. Las decisiones sobre los datos y las definiciones de las variables se basan en el conocimiento del sector adquirido en la negociación fundamental/discrecional de materias primas, que podría revisarse con el tiempo. Sin embargo, dado que el enfoque se centra en factores estacionarios, el principio aplicado es fijar también los aspectos relativos a los datos, para evitar un posible sobreajuste a través de ese proceso de revisión o actualización.
- El entrenamiento y la selección de los modelos de activos se basan estrictamente en datos disponibles hasta finales de 2016, lo que coincide además con el periodo a partir del cual se fijaron los modelos de asignación de la mayoría de las materias primas líquidas, que pasaron a estar disponibles en negociación real. Por este motivo, ese periodo se utiliza también para el entrenamiento/validación de nuevas investigaciones y nuevos modelos de activos.
- Optimizar dentro de la muestra los parámetros del método final de asignación de activos podría dar lugar a un sesgo de selección. Sin embargo, el rango de valores está acotado, de modo que no se espera que tenga un efecto drástico en los resultados, y estos se validan por la ausencia de un sobreajuste significativo en los resultados fuera de muestra.
- Para probar el modelo completo de asignación de activos del proceso previo, todos sus detalles deben estar fijados antes de obtener los resultados de prueba fuera de muestra con datos reservados a partir del 1 de enero de 2017. La práctica estricta de fijar el método y utilizar los conjuntos de datos reservados para la evaluación final del proceso previo, habitual en la comunidad de ML, se ha elegido como medida principal para reducir el riesgo de subestimar, o de incluir accidentalmente, un efecto que embellezca los resultados debido a un sesgo de pruebas múltiples. Por el mismo motivo, la mayoría de los modelos de asignación de activos líquidos se fijaron a partir del 1 de enero de 2017 y no se han modificado desde entonces, lo que proporciona resultados fuera de muestra en tiempo real.
- La construcción de índices en el proceso posterior implica parámetros que, en su mayoría, tienen un efecto moderado sobre el rendimiento, como el objetivo de volatilidad y los límites de asignación, y cuyas decisiones suelen basarse en objetivos prácticos más que en el rendimiento del índice. No obstante, hay que actuar con cuidado, sobre todo en la selección de los activos del índice, que tiene una mayor influencia en el rendimiento. En este caso, el principio general es considerar los activos en igualdad de condiciones e introducir distinciones entre ellos solo si están justificadas en la fase de entrenamiento y respaldadas por los resultados de las pruebas fuera de muestra.