CTA-Signalmodellierung
Aus dem Englischen übersetzt. Maßgeblich ist der englische Text. Auf Englisch lesen
Fragestellungen
Lässt sich mit den folgenden Ansätzen ein Modell des überwachten Lernens für eine CTA-Strategie erstellen?
- Chronologische Aufteilung der Daten
- Um Datenlecks (Data Leakage) zu vermeiden und einen sachgerechten Backtest zu simulieren
- Zufälliges Upsampling (nicht synthetisch)
- Zum Umgang mit unausgewogenen Klassen
- Modellierung mit Feature-Transformation durch Ensemble-Baumalgorithmen
Wesentliche Eingaben der Aufgabe:
- Stichtage
- Beginn der Validierung
- Beginn des Holdouts
- Ende des Holdouts
- Optimierungsmetrik (Accuracy, Precision, Recall, F1, Neg Log Loss)
- Trainingsfrequenz (Jahr, Quartal, Monat, Tag)
Ergebnisse:
- Prognostizierte Signale, jeweils Long oder Short
- Aggregierte Kennzahlen für Validierung und Holdout im Vergleich
- Konfusionsmatrizen für Validierung und Holdout im Vergleich
- Finale Hyperparameter des Modells
Chronologische Aufteilung der Daten
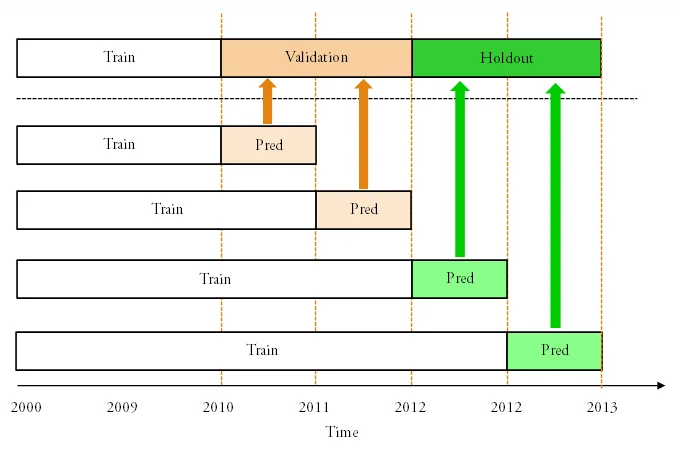
- Chronologische Aufteilung der Daten in Trainings-, Validierungs- und Holdout-Abschnitte
- Setzt einen Backtest mit festem Zeitintervall für das erneute Training des Modells voraus
- Jährlich
- Vierteljährlich
- Monatlich
- Täglich
- Validierungszeitraum:
- Die Prognosen dieses Zeitraums werden bewertet und für die Abstimmung der Hyperparameter verwendet
- Holdout-Zeitraum:
- Die Prognosen dieses Zeitraums werden erfasst, aber für keinerlei Abstimmung verwendet
Zufälliges Upsampling (nicht synthetisch)
- Die Signalmodellierung ist ein binäres Klassifikationsproblem
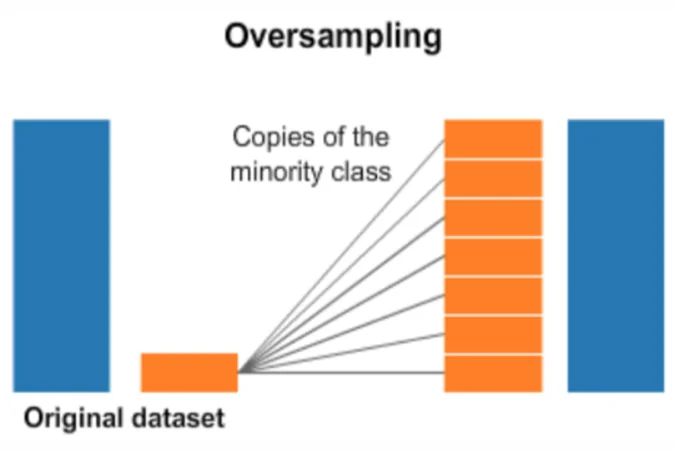
- Die Signale von CTA-Assets sind tendenziell stark unausgewogen (Verhältnis von etwa 1:4)
- Ein direkt angewandtes ML-Modell würde daher meist die Mehrheitsklasse prognostizieren
- Vorgehen
- Die Minderheitsklasse wird durch nicht synthetisches, zufälliges Upsampling auf ein Verhältnis von 1:1 gebracht
- Das Upsampling wird mit einem reproduzierbaren Zufalls-Seed umgesetzt
Modellierungsmethodik
Modellrahmen
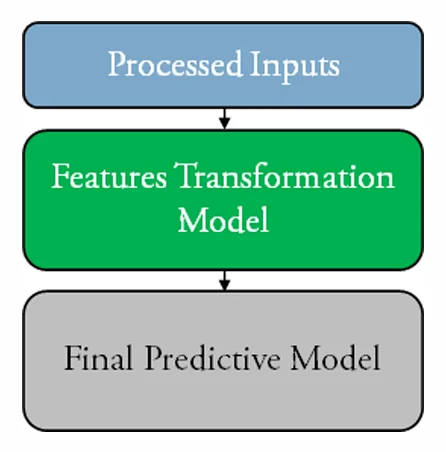
- Eingaben -> Ensemble-Baummodell zur Feature-Transformation (FT) -> One-Hot-Encoding -> finales Prognosemodell
FT-Ensemble-Baummodell:
- Einsatz eines Ensemble-Baumalgorithmus des überwachten Lernens zur Feature-Transformation
- Vorgehen:
- Zunächst auf den Trainingsdaten trainiert (und nie mit Testdaten in Berührung gebracht)
- Anschließend als Schritt der Feature-Transformation eingesetzt, bei dem:
- vorverarbeitete Daten in das Modell eingespeist werden
- die Blätter jedes Baums als Eingabe-Features für das nächste Modell dienen
- Hilft, nichtlineare Zusammenhänge in den Daten zu erfassen, und wirkt zugleich als eine Form der Regularisierung
Finales Prognosemodell:
- Gradient-Boosting-Baumalgorithmus nach aktuellem Stand der Technik
- Übernimmt die one-hot-kodierten, transformierten Features der vorherigen Ebene und erstellt eine binäre Klassifikationsprognose
CTA-Modellierungsprozess
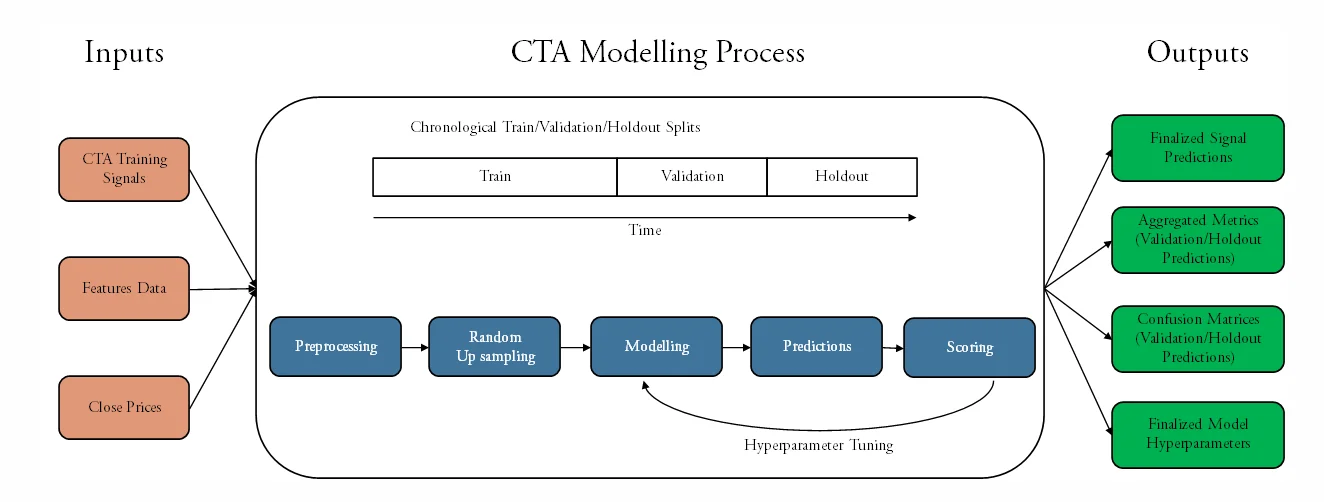
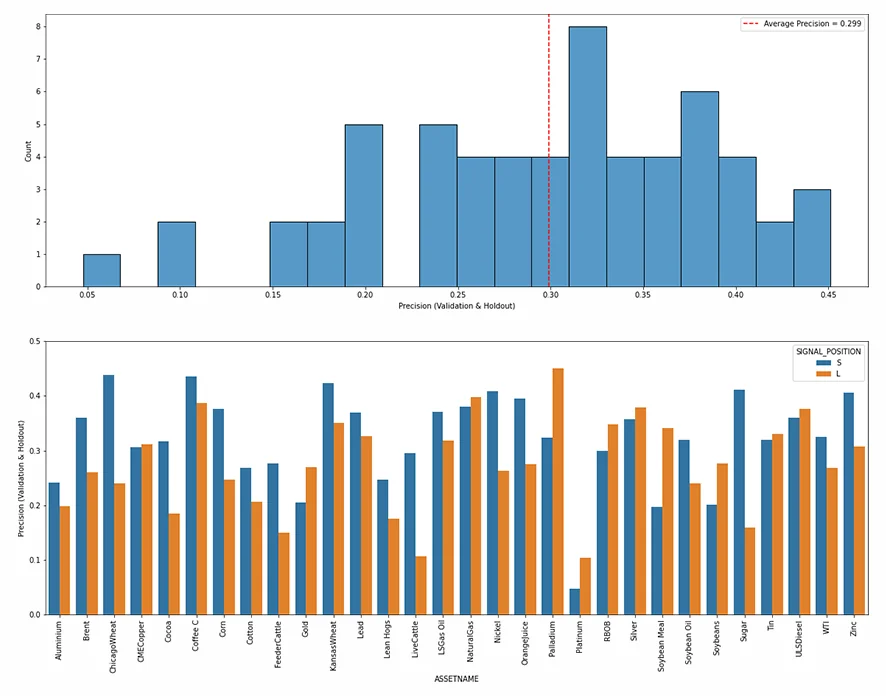
Präzisionsdiagramme
Präzision = (richtig Positive)/(prognostizierte Positive) für die zusammengefassten Prognosen der Validierungs- und Holdout-Zeiträume, je Signalposition (Long/Short)
Diagramm 1: Histogramm der Präzision:
- 30 Assets x 2 Signalpositionen = 60
- Durchschnitt = 0.299
- Der Modus liegt zwischen 0.30 und 0.35
Diagramm 2: Balkendiagramm der Präzision je Asset
- Jedes Asset hat zwei Präzisionswerte (einen je Signalposition)
- Bei den meisten Assets sind die Präzisionswerte für beide Signalpositionen ähnlich